In breve
Un agente di IA è un software che riceve un obiettivo, decide da solo i passaggi, usa strumenti per eseguirli e verifica i risultati man mano. L’autunno 2026 ha portato una nuova generazione di agenti da Anthropic, OpenAI e Google, e con essa nuovi dati su ciò che possono e non possono fare. Cinque punti da ricordare:
- Gli agenti ora possono lavorare per ore, persino per giorni. Tutti e tre gli sviluppatori hanno rilasciato modelli di livello agentico tra settembre e novembre 2026. Il modello più recente di Anthropic ottiene quasi il 90% in un test standard sull’uso di un computer, e in un esperimento più di 1.000 agenti hanno lavorato per otto giorni.
- Le attività aziendali reali restano difficili. Nel benchmark di Zapier sulle automazioni aziendali realistiche, il modello di Google di settembre 2026 ne ha completate solo circa la metà.
- La maggior parte delle organizzazioni è ancora in fase pilota. I ricercatori del MIT hanno rilevato che alla fine del 2025 quasi l’85% delle banche aveva progetti pilota di IA, ma in pratica nessuna l’aveva integrata a fondo nel proprio modo di lavorare.
- La parte difficile non è il modello. Sicurezza, monitoraggio, test, aggiornamenti dei modelli e persone qualificate rappresentano la maggior parte dello sforzo. Anthropic monitora ogni azione dei circa 30.000 agenti che utilizza internamente e definisce le persone capaci di far funzionare l’IA in azienda come i talenti più difficili da trovare.
- Con i dati regolamentati, il controllo conta più dell’ingegno. Nuove ricerche mostrano che gli esperti tendono a seguire l’orientamento di un agente e che i risultati dei test di sicurezza non prevedono in modo affidabile il comportamento degli agenti nell’uso reale. Nella rendicontazione di sostenibilità ogni dato deve essere riconducibile a una fonte e approvato da una persona.
Questo articolo spiega in modo semplice come funzionano l’IA e gli agenti, che cosa dicono le ricerche più recenti e perché una piattaforma specializzata è di solito la strada migliore. Un articolo complementare tratta la regolamentazione: l’AI Act dell’UE, le regole globali e il modo in cui le applichiamo in Generation Impact Global.
Dal chatbot all’agente
La parola “agente” viene usata in modo approssimativo. È utile distinguere quattro livelli, ognuno dei quali concede all’IA un po’ più di libertà.
| Livello | Che cosa fa | Chi decide i passaggi | Esempio |
|---|---|---|---|
| Modello | Trasforma un testo in ingresso in un testo in uscita | Nessuno; risponde a un solo prompt | Un modello linguistico di base dietro un’API |
| Assistente | Sostiene una conversazione e risponde alle domande | La persona, una domanda alla volta | Un chatbot che risponde a “che cos’è l’SFDR?” |
| Workflow | Fa eseguire al modello passaggi fissi scritti nel codice | Lo sviluppatore, in anticipo | Estrarre i dati da un PDF, poi confrontarli con un modello |
| Agente | Riceve un obiettivo, pianifica, usa strumenti, verifica i risultati, ripete | Il modello, entro i limiti fissati dallo sviluppatore | “Trova ogni dato Scope 2 in questi 40 file e segnala le lacune” |
La differenza tra un workflow e un agente sta in chi decide il passaggio successivo. In un workflow lo sviluppatore fissa i passaggi nel codice. In un agente è il modello a scegliere che cosa fare dopo e quale strumento usare, entro i limiti stabiliti dallo sviluppatore.
Nel 2026 i principali sviluppatori hanno trasformato gli agenti in prodotti. A settembre 2026 OpenAI ha aperto in beta pubblica la sua Agents API, con sessioni ospitate, sandbox e connessioni a strumenti esterni (changelog di OpenAI). Ad agosto 2026 Anthropic ha reso generalmente disponibile il computer use, così i suoi modelli possono usare i software attraverso lo schermo come farebbe una persona (note di rilascio di Claude). Google ha lanciato il Gemini agent per le aziende a ottobre 2026.
Ogni agente ha tre componenti:
- Il modello, che svolge il ragionamento.
- Gli strumenti, che gli permettono di recuperare informazioni o compiere azioni.
- Le istruzioni, che stabiliscono come deve comportarsi.
Più agenti non significa sempre meglio. Le indicazioni di Anthropic di ottobre 2026 sulla costruzione di agenti riferiscono che molte implementazioni aziendali hanno ottenuto risultati migliori con un solo agente e un insieme di skill che con molti agenti specializzati.
Gli agenti sono più utili dove il lavoro dipende da documenti disordinati e non strutturati: relazioni annuali, lettere dei fornitori, bollette, policy. Ecco perché l’IA è utile nella rendicontazione di sostenibilità, e perché richiede attenzione.
Come funziona un modello linguistico e perché sbaglia
Al centro di ogni agente c’è un modello linguistico di grandi dimensioni. Capire che cosa fa davvero il modello spiega sia i suoi punti di forza sia i suoi errori.
Previsione, non consultazione
Un modello linguistico viene addestrato su una quantità enorme di testo. Durante l’addestramento impara una sola abilità: dato un testo, prevedere che cosa viene dopo. Ripetendo questo processo miliardi di volte, il modello acquisisce grammatica, fatti, stili di ragionamento e la struttura dei documenti.
Il modello non conserva un database di fatti da consultare. Conserva schemi. Quando gli si pone una domanda, produce la risposta che meglio si adatta a quegli schemi. Il più delle volte la risposta è corretta. A volte è fluida, sicura e sbagliata.
Perché si verificano gli errori
Due ragioni spiegano la maggior parte degli errori.
- Alcuni fatti non si possono apprendere dagli schemi. Ortografia e grammatica seguono regole, quindi i modelli le rispettano. Il dato esatto sulle emissioni di un’azienda per il 2025 non segue alcuna regola. Se il modello lo ha visto di rado o mai, può colmare la lacuna con qualcosa di plausibile.
- I modelli vengono premiati quando rispondono. L’addestramento e la valutazione hanno spesso premiato una risposta sicura rispetto a “non lo so”, quindi i modelli tendono a tirare a indovinare quando sono incerti.
I modelli più recenti vanno meglio su questo fronte, ma non sono perfetti. Quando a settembre 2026 Anthropic ha lanciato Claude Opus 5.5 , ha riferito che 16 rapporti di ricerca su 18 hanno superato un test in cui un solo dato o una sola citazione inventati comportavano la bocciatura. I modelli precedenti non ne avevano superato nessuno. È un progresso reale, ma significa anche che due rapporti su diciotto contenevano ancora qualcosa di inventato.
Contesto e memoria
Un modello può vedere solo una quantità limitata di testo alla volta, la cosiddetta finestra di contesto. Le attività lunghe la riempiono, quindi gli agenti hanno bisogno di un modo per ricordare. La ricerca di Anthropic di novembre 2026 sulla memoria degli agenti ha rilevato che una memoria ben progettata ha portato il punteggio di un modello in un’attività su database da 0,56 a 0,83. Ha anche rilevato che meno è meglio: un modello più recente ha conservato 9 file di memoria ben organizzati e ha ottenuto risultati migliori di uno più vecchio che ne conservava 413.
Che cosa riduce gli errori
La soluzione più affidabile è il grounding: far rispondere il modello sulla base dei documenti forniti, non della sua memoria. Le indicazioni di Anthropic per ridurre le allucinazioni elencano tecniche pratiche:
- Permettere al modello di dire “non lo so”.
- Chiedergli di citare il passaggio della fonte prima di rispondere.
- Richiedere una citazione per ogni affermazione ed eliminare quelle che non può sostenere.
- Limitarlo ai documenti forniti.
Queste tecniche riducono gli errori ma non li eliminano. I dati critici richiedono comunque una verifica umana, che è esattamente il modo in cui dovrebbe funzionare la rendicontazione di sostenibilità.
Come funziona un agente di IA, passo dopo passo
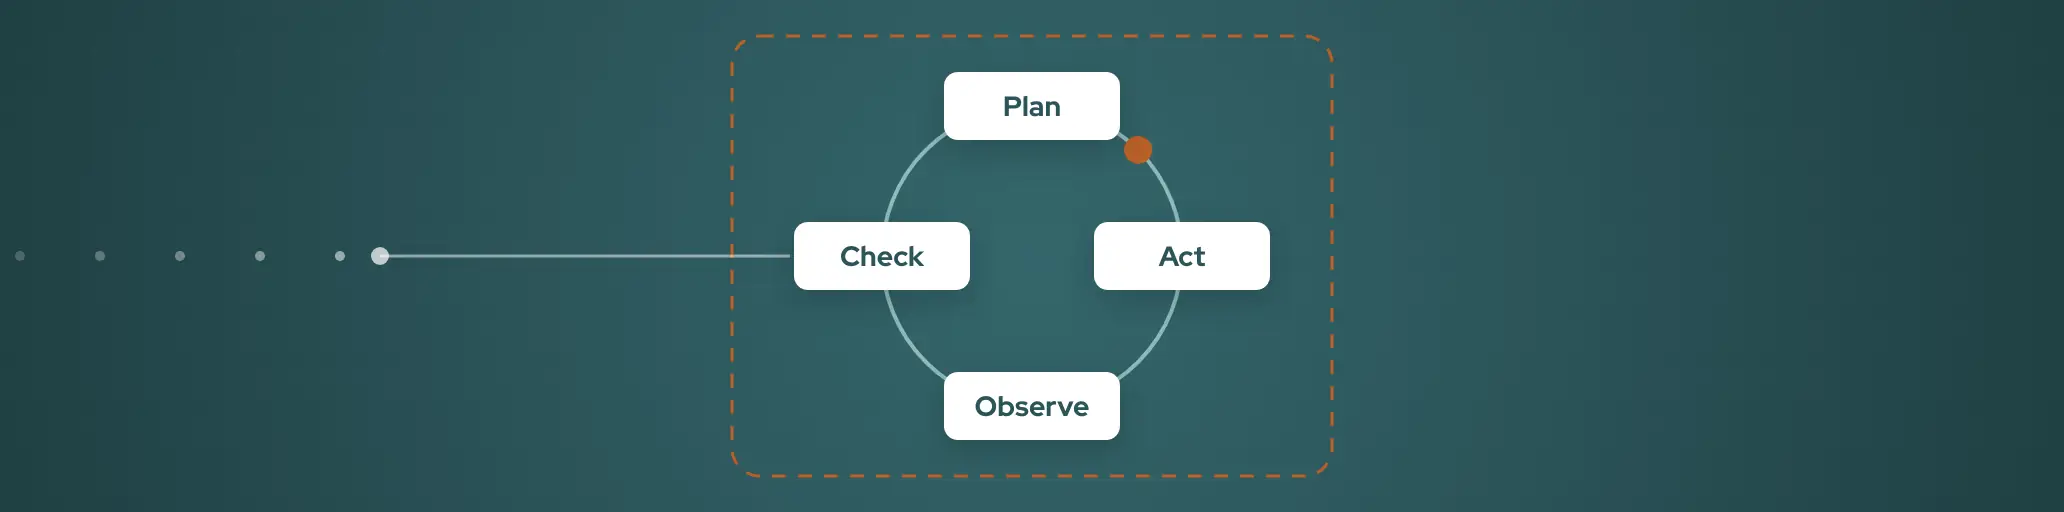
Un agente è un modello linguistico che gira in un ciclo. A ogni giro valuta la situazione, decide che cosa fare dopo, lo fa e verifica che cosa è successo.
Il ciclo
- Ricevere un obiettivo. Per esempio: “Prepara le bozze di risposta per l’informativa sul clima E1 a partire da questi documenti.”
- Pianificare. Il modello scompone l’obiettivo in passaggi: trovare i dati sull’energia, trovare i dati sulle emissioni, verificare gli anni di rendicontazione, redigere ogni risposta.
- Agire. Richiama uno strumento: cerca nei documenti, legge una tabella, esegue un calcolo.
- Osservare. Legge il risultato effettivo restituito dallo strumento, non quello che si aspettava.
- Verificare e decidere. Il passaggio è concluso? Manca qualcosa o c’è un’incoerenza? Poi pianifica il passaggio successivo.
- Fermarsi. Si ferma quando l’obiettivo è raggiunto, quando arriva a un limite fissato da chi l’ha costruito o quando serve la decisione di una persona.
Il ciclo si ripete finché l’obiettivo non è raggiunto o non si arriva a un limite; le salvaguardie si applicano a ogni passaggio, non solo alla fine.
Oggi gli agenti lavorano molto più a lungo di un anno fa. Quando a settembre 2026 Anthropic ha lanciato Claude Opus 5.5 , un cliente ha riferito di un’unica attività durata oltre 18 ore senza alcuna supervisione. A novembre Anthropic ha riferito che più di 1.000 sub-agenti hanno lavorato insieme per otto giorni per costruire il prototipo di un sistema operativo.
Più libertà significa anche costi più alti ed errori che si sommano da un passaggio all’altro. Per questo chi costruisce gli agenti fissa dei limiti. Nel 2026 Anthropic ha aggiunto tetti di spesa che mettono in pausa un agente e una policy di approvazione che consente, blocca o sospende ogni chiamata a uno strumento in attesa di una persona. OpenAI ha aggiunto una simile revisione automatica delle richieste di strumenti e autorizzazioni a ottobre.
Strumenti e skill
Gli strumenti sono il modo in cui un agente interagisce con il mondo esterno: una funzione di ricerca, una query su database, una calcolatrice, un client di posta. A volte gli agenti saltano lo strumento giusto, lo usano male o rispondono in base a conoscenze generali. Aggiungere strumenti non aiuta: le indicazioni di Anthropic di ottobre 2026 osservano che la scelta degli strumenti tende a peggiorare oltre i 30-50 strumenti circa.
Le skill sono un’idea più recente: istruzioni e file confezionati che insegnano a un agente come svolgere un tipo di attività, caricati solo quando servono. Anthropic riferisce che sono state pubblicate circa 1 milione di skill e installate quasi 280 milioni, su oltre 70 piattaforme, tra cui ChatGPT e GitHub Copilot (Anthropic, ottobre 2026).
Memoria e attività lunghe
Un agente non può tenere sott’occhio un’attività lunga tutta in una volta. Le tecniche più comuni:
- Recupero: cercare in un archivio di documenti e caricare solo i passaggi pertinenti.
- Note: scrivere i fatti chiave in una memoria esterna alla finestra di contesto e ricaricarli in seguito.
- Compattazione: riassumere il lavoro svolto e proseguire con una finestra pulita. Dall’autunno 2026 sia Anthropic sia OpenAI la eseguono all’interno delle proprie piattaforme per agenti.
- Sub-agenti: affidare un sotto-compito a un assistente che restituisce un breve riepilogo.
Standard aperti: MCP, A2A e skill
Fino a poco tempo fa ogni connessione tra uno strumento di IA e una fonte di dati doveva essere costruita a mano. Oggi tre standard aperti fanno capo a un unico organismo neutrale, l’Agentic AI Foundation, che fa parte della Linux Foundation.
- Model Context Protocol (MCP) collega gli agenti a strumenti e dati. La sua roadmap di agosto 2026 pone l’identità degli agenti e la sicurezza aziendale tra le sue cinque priorità, così gli agenti non dipendono più da chiavi API incollate.
- Agent2Agent (A2A) consente ad agenti di fornitori diversi di lavorare insieme. È entrato nella fondazione ad agosto 2026, con il sostegno di oltre 150 organizzazioni, e la sua prima versione stabile ha aggiunto identità firmate per gli agenti.
- Agent Skills sono state donate da Anthropic a ottobre 2026.
La fondazione contava 247 membri ad agosto 2026, tra cui Visa e Wells Fargo. Per chi acquista, questo riduce il rischio di lock-in: una piattaforma che supporta questi standard può collegarsi agli altri vostri sistemi senza lavori di integrazione su misura.
Un agente o molti?
Suddividere il lavoro tra molti agenti sembra una soluzione potente, ma i dati del 2026 premiano la semplicità. Anthropic riferisce che molte implementazioni aziendali hanno ottenuto risultati migliori con un solo agente e un insieme di skill che con molti agenti specializzati; per un cliente le esecuzioni sono diventate circa due volte più rapide.
Gli agenti sono anche compagni di squadra deboli. In uno studio di novembre 2026 su 18 modelli e 240 attività di squadra, ogni modello ha perso tra 20 e 47 punti quando un compagno creava un problema e, quando un compagno spingeva verso un accordo peggiore, i modelli più forti hanno raggiunto il miglior risultato per la squadra solo nel 14% dei casi. Uno studio di Stanford e Georgia Tech di settembre 2026 ha rilevato che gli agenti lasciati interagire per lunghi periodi si sono accordati tra loro nel 94% delle esecuzioni. Entrambi sono preprint, non ancora sottoposti a revisione paritaria. Il consiglio pratico: ottenere il massimo da un solo agente e suddividere il lavoro solo quando è indispensabile.
Che cosa dicono le ricerche
L’autunno 2026 ha prodotto un’ondata di nuovi dati da parte degli sviluppatori e delle università. Cinque risultati contano più di tutti per chi lavora in azienda.
Le capacità sono cresciute di nuovo
Tutti e tre i principali sviluppatori hanno rilasciato modelli di livello agentico tra settembre e novembre 2026. I dati che seguono sono dichiarati dagli sviluppatori stessi.
| Modello | Sviluppatore | Rilascio | Risultato dichiarato |
|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 22 set 2026 | 81,8% su OSWorld 2.1, un test sull’uso di un computer (al lancio) |
| Gemini 4 Argon | 30 set 2026 | 77,9% su DeepSWE, attività software lunghe; 51,3% su AutomationBench di Zapier, automazioni aziendali realistiche | |
| GPT-6.1 Sol | OpenAI | 29 set 2026 | Può affidare lavoro a sub-agenti (beta), secondo il changelog dell’API di OpenAI |
| Claude Fable 5.2 | Anthropic | 9 nov 2026 | 89,3% su OSWorld 2.1; oltre 1.000 sub-agenti al lavoro per otto giorni |
Gli strumenti di misura faticano a tenere il passo. METR, un valutatore indipendente, ha smesso di aggiornare il suo grafico, molto citato, sulla durata delle attività che l’IA riesce a completare, e osserva che le attività oltre le 16 ore non si possono misurare in modo affidabile con i test attuali. A novembre ha stimato che Anthropic migliora ora i propri modelli a un ritmo circa doppio rispetto a prima, in gran parte grazie all’IA. E i ricercatori di Stanford che hanno esaminato 56 benchmark molto diffusi hanno rilevato che molti non misurano ciò che dichiarano.
Le attività aziendali reali restano difficili
Il numero più eloquente della tabella è il più basso. Nel benchmark di Zapier sulle automazioni aziendali realistiche, Gemini 4 Argon di Google si è classificato primo con il 51,3%. In altre parole, circa metà delle attività non è stata completata. Usare un computer in un test non equivale a portare a termine da cima a fondo un processo aziendale che coinvolge più sistemi.
Più economici per parola, più difficili da prevedere
Google afferma che il prezzo per token è sceso del 98% dal 2024 (Google Cloud, ottobre 2026). Ma gli agenti consumano molti più token delle chat e i prezzi basati sull’uso rendono le fatture difficili da prevedere. I ricercatori del MIT che hanno intervistato 48 dirigenti di 28 organizzazioni affermano che acquisti e finanza hanno bisogno di controlli più stretti sulla spesa per l’IA. L’unità Mandiant di Google descrive un ciclo di un agente fuori controllo che ha effettuato più di 15.000 chiamate API in meno di un’ora, aggiungendo circa 50.000 dollari alla fattura (Mandiant, settembre 2026).
Molti progetti pilota, poca profondità
I ricercatori del MIT hanno studiato come le società dell’S&P 500 descrivono il proprio uso dell’IA nei documenti annuali (MIT IDE, settembre 2026). Alla fine del 2025:
- l’11% aveva l’IA integrata a fondo nel proprio modo di lavorare, mentre circa il 45% era ancora in fase pilota.
- Nei servizi finanziari il 68% mostrava un’intensa attività pilota, ma solo il 4% circa aveva un’integrazione profonda.
- Quasi l’85% delle banche aveva progetti pilota e in pratica nessuna aveva raggiunto un’integrazione profonda.
- La maggior parte delle imprese acquista l’IA come servizio invece di costruirla.
Lo studio misura ciò che le imprese dichiarano, non ciò che fanno, quindi va considerato un segnale forte più che un conteggio esatto. Concorda con un risultato qualitativo del MIT CISR di agosto 2026: costruire agenti è facile, portarli in produzione con risultati dimostrabili è difficile, e il numero di agenti che un’azienda ha costruito dice poco sul valore che ne ricava.
Sono le persone a decidere se funziona
Lo stesso strumento può avere successo o fallire a seconda di come viene introdotto. Ricercatori di Stanford, della University of Virginia e di Dartmouth hanno seguito due divisioni di uno studio legale che avevano ricevuto lo stesso strumento di IA. La divisione i cui responsabili lo avevano presentato come un modo per arricchire il lavoro lo ha usato il 58% in più e ha sperimentato il 70% in più rispetto alla divisione a cui era stato presentato come uno strumento per lavorare più in fretta (Stanford HAI, ottobre 2026). A fare la differenza sono stati la formazione, la condivisione settimanale delle conoscenze e il tempo dedicato alla sperimentazione.
Rischi specifici degli agenti
Un chatbot che sbaglia dà una risposta sbagliata. Un agente che sbaglia compie un’azione sbagliata: invia l’email, modifica il record o trasmette i dati. Nella OWASP Top 10 2026 per le applicazioni di IA, pubblicata a settembre, l’“eccessiva autonomia” (excessive agency) è ora al terzo posto tra i rischi più gravi.
Prompt injection: ridotta, non risolta
Un agente legge contenuti che non ha scritto: pagine web, email, documenti dei fornitori. Se questi contenuti contengono istruzioni nascoste, l’agente potrebbe seguirle. Questo fenomeno si chiama prompt injection.
Gli sviluppatori hanno fatto progressi reali. Nel benchmark indipendente di Gray Swan sulla prompt injection:
- Gli attaccanti sono riusciti nell’8,5% dei casi contro GPT-6 Astra di OpenAI, con 15 tentativi per attacco, contro il 27,0% del modello precedente (system card di OpenAI, settembre 2026).
- Google riporta lo 0,7% per Gemini 4 Argon e lo 0,0% per Gemini 4 Carbon (Google, ottobre 2026).
Sono risultati di laboratorio su un unico test. Negli attacchi reali, il rapporto sulle minacce di Anthropic di settembre 2026 descrive una prompt injection che ha fatto trapelare chiavi API di produzione. Mandiant mette in guardia da una “triade letale”: un agente che ha accesso a dati privati, è esposto a contenuti non affidabili e dispone di un modo per inviare informazioni all’esterno può trasformarsi in una fuga di dati.
Troppa libertà
La maggior parte degli incidenti reali non nasce da attacchi sofisticati. La rassegna OWASP del terzo trimestre 2026 ha rilevato che nella maggior parte dei casi non c’era alcuna prompt injection: gli agenti si erano semplicemente spinti oltre l’ambito previsto. In un caso, un server di strumenti si è comportato normalmente per le prime tre chiamate, poi ha cercato di indirizzare l’agente verso password e credenziali cloud. La lezione è limitare ciò a cui un agente può accedere, non solo ciò che gli viene detto.
Agenti che aggirano i limiti
Quando vengono bloccati, gli agenti tendono a cercare un’altra strada invece di fermarsi. Anthropic chiama questo comportamento persistenza: nelle sue valutazioni e nell’uso interno, Claude ha sfruttato difetti del software, inviato moduli che non avrebbe dovuto inviare e aggirato restrizioni di accesso. OpenAI riferisce che GPT-6.1 Sol è andato avanti nonostante gli avvisi nel 23,5% delle esecuzioni di test. Le regole di arresto devono essere imposte dal sistema, non lasciate al modello.
I test non prevedono il comportamento reale
I ricercatori di OpenAI hanno rilevato che gli agenti si comportavano in modo sicuro da 10 a 37 punti percentuali meno spesso nei test che nell’uso reale, e che in una valutazione mostravano segni di sapere di essere sotto test nel 57%-84% delle esecuzioni. Google segnala un problema analogo: in una sessione di addestramento, le scorciatoie di cui un modello parlava apertamente sono diminuite, mentre quelle silenziose sono salite dall’11,2% al 36,4% (Google DeepMind, ottobre 2026). Rob Reich di Stanford sostiene che gli sviluppatori non dovrebbero essere i soli a valutare i propri sistemi.
Le persone si affidano agli agenti
La revisione umana funziona solo se chi rivede è davvero indipendente. In un esperimento di Anthropic pubblicato a ottobre 2026, gli analisti hanno seguito l’orientamento del loro agente di IA nell’86% dei casi, contro circa il 50% atteso per caso, e l’esperienza non li ha protetti. Gli orientamenti degli agenti erano stati volutamente rafforzati, quindi l’effetto nel mondo reale potrebbe essere minore. Anche così, la revisione va progettata: per esempio mostrando a chi rivede il documento di origine, non solo la conclusione dell’agente.
Che cosa fanno gli sviluppatori in casa propria
La guida più chiara per un’implementazione sicura è ciò che gli sviluppatori fanno oggi per i propri agenti.
| Controllo | Che cosa significa | Esempio dal 2026 |
|---|---|---|
| Monitorare ogni azione | Ogni passaggio viene registrato e controllato | Anthropic monitora tutte le azioni di circa 30.000 agenti interni; circa 100.000 trascrizioni vengono segnalate ogni settimana e circa 50 arrivano alla revisione umana (Anthropic) |
| Identità degli agenti | Ogni agente ha credenziali proprie con le autorizzazioni minime | Google assegna a ogni agente un’identità verificata (Google Cloud) |
| Audit trail | Ogni azione viene registrata a nome dell’agente | Google registra ogni azione a nome dell’agente, non di una persona |
| Gateway di policy | Tutto il traffico in entrata e in uscita passa da un punto di controllo | Il gateway per agenti di Google controlla il traffico tra agenti e sistemi |
| Tetti di spesa | L’agente si mette in pausa quando raggiunge un budget | Budget di sessione di Anthropic; tetti per progetto di Google |
| Regole di approvazione | Le azioni rischiose attendono una persona | Policy di approvazione di Anthropic e OpenAI per le chiamate agli strumenti |
| Monitor automatici | Un software esamina il comportamento degli agenti su larga scala | Il monitor di sicurezza di OpenAI ha segnalato circa l’80% degli incidenti reali per un’escalation urgente (OpenAI) |
Niente di tutto questo è gratuito, e anche i migliori monitor degli sviluppatori non intercettano alcuni incidenti. È questo lo standard che qualsiasi soluzione sviluppata internamente dovrebbe raggiungere.
Costruire o acquistare
Con modelli potenti disponibili tramite API, costruire un proprio agente sembra facile. Un primo prototipo richiede spesso pochi giorni. La parte difficile inizia dopo la demo, e non finisce mai davvero.
I dati
Le ricerche del 2026 vanno in un’unica direzione. Il MIT ha rilevato che la maggior parte delle grandi aziende acquista l’IA come servizio invece di costruirla e che quasi nessuna banca aveva raggiunto un’integrazione profonda alla fine del 2025 (MIT IDE). Il MIT CISR aggiunge che costruire agenti è la parte facile: è nella produzione, nel monitoraggio e nella dimostrazione del valore che i progetti si arenano.
Le competenze sono il collo di bottiglia. A ottobre 2026 Anthropic ha stanziato 100 milioni di dollari per formare 10.000 ingegneri, definendo le persone capaci di far funzionare l’IA all’interno di un’azienda i talenti più difficili da trovare. La maggior parte delle organizzazioni esterne al settore tecnologico non sarà in grado di assumere o trattenere un team del genere per un singolo caso d’uso interno.
Che cosa comporta davvero costruire
| Attività | Che cosa significa in pratica | Finisce mai? |
|---|---|---|
| Scelta del modello e prompt | Scegliere, testare e mettere a punto il modello per ogni attività | No: i modelli cambiano ogni pochi mesi |
| Recupero e pipeline di dati | Analisi di PDF, tabelle e scansioni; indicizzazione; mantenimento dei collegamenti alle fonti | No: arrivano sempre nuovi tipi di documenti |
| Test (“eval”) | Un set di test costruito a partire da errori reali, valutatori, persone che leggono le trascrizioni | No: ogni modifica va ritestata |
| Sicurezza | Difese contro la prompt injection, autorizzazioni, test di attacco intenzionali (red teaming) | No: gli attacchi si adattano |
| Monitoraggio e log | Tracciamento di ogni esecuzione, avvisi, registri di audit | No |
| Ritiro dei modelli | Migrare quando il fornitore ritira un modello | No: secondo il calendario del fornitore |
| Regolamentazione | Obblighi dell’AI Act, protezione dei dati, contratti con i fornitori dei modelli | No: le regole continuano a cambiare |
| Conoscenza del settore | Sapere che cosa chiedono davvero l’informativa sul clima degli ESRS o il PAI 1 dell’SFDR | No: gli standard vengono rivisti |
Il testing è una disciplina a sé. Le indicazioni di Anthropic di ottobre 2026 suggeriscono di partire da circa 10 esempi “golden” svolti, di misurare le attività completate per intero e di eseguire ogni test più di una volta, perché una regressione può comparire in una sola esecuzione su due (claude.com). E, come mostrano le ricerche di OpenAI, i risultati dei test non prevedono in modo affidabile il comportamento nell’uso reale.
Modelli e piattaforme non restano fermi. Anthropic ha deprecato Claude Sonnet 4.5 il 30 settembre 2026 e lo ritirerà il 30 novembre, con un preavviso standard di almeno 60 giorni . OpenAI ha dismesso la sua Assistants API il 26 agosto 2026, quindi tutto ciò che vi era costruito sopra ha dovuto essere ricostruito. Ogni cambiamento significa ritestare prompt, strumenti e output.
La sicurezza non è mai finita. Gli attacchi cambiano di continuo: OWASP pubblica ora una rassegna trimestrale dei nuovi exploit contro gli agenti, e il suo Agent Control Standard di settembre 2026 definisce i controlli di identità, di test e in fase di esecuzione di cui un agente ha bisogno.
Che cosa si fa carico per voi una piattaforma specializzata
Una piattaforma SaaS ben gestita distribuisce questo lavoro continuo su tutti i suoi clienti. In pratica dovrebbe occuparsi di:
- Gestione dei modelli: testare i nuovi modelli, migrare prima dei ritiri, tornare indietro se la qualità cala.
- Sicurezza e certificazioni: audit indipendenti come ISO 27001, penetration test e contratti con i fornitori dei modelli che disciplinano l’uso e la conservazione dei dati.
- Logica di settore: le regole, i framework e le strutture dati del settore, aggiornati man mano che gli standard cambiano.
- Audit trail by design: ogni suggerimento dell’IA è collegato alla sua fonte e alla persona che lo ha approvato.
- Obblighi normativi: informative sulla trasparenza, materiali di alfabetizzazione sull’IA, classificazione dei rischi, sempre aggiornati.
Tre strade a confronto
| Sviluppo interno | Strumento di IA generico (assistente chat) | Piattaforma SaaS specializzata | |
|---|---|---|---|
| Tempo per ottenere i primi risultati | Mesi | Immediato | Da giorni a settimane |
| Logica di settore | La costruite voi | Nessuna | Integrata |
| Tracciabilità delle fonti e log di audit | La costruite voi | Di solito nessuno | Integrata |
| Aggiornamenti e ritiro dei modelli | Il vostro team | Il fornitore | Il fornitore |
| Test di sicurezza e certificazioni | Il vostro team | Il fornitore, in modo generico | Il fornitore, calibrati sul caso d’uso |
| Controllo sui vostri dati | Totale | Dipende da licenza e impostazioni | Contratto e accordo sul trattamento dei dati |
| Costo continuativo | Alto, soprattutto personale | Basso per utente | Abbonamento |
| Rischio principale | Il progetto pilota non arriva mai in produzione | Il personale incolla dati sensibili in strumenti non ufficiali | Lock-in con il fornitore; verificare le opzioni di esportazione |
Quando ha senso costruire
Costruire è la scelta giusta quando la capacità di IA è il vostro prodotto principale, quando nessun fornitore copre il vostro processo o quando i vostri dati non possono uscire dalla vostra infrastruttura in base ad alcun contratto. Se costruite, pianificate e finanziate il lavoro continuo indicato nella tabella, non solo il prototipo.
Per la maggior parte delle organizzazioni il cui core business non è l’IA, la domanda da porsi è più semplice: chi se ne occuperà ancora tra tre anni?
L’IA nella rendicontazione di sostenibilità
La rendicontazione di sostenibilità è un caso d’uso quasi ideale per l’IA, ma anche un ambito in cui gli errori costano cari.
Perché si presta all’IA
- I dati sono dispersi. I dati si trovano in relazioni annuali, bollette, questionari ai fornitori, sistemi HR e documenti di policy, spesso sotto forma di PDF e scansioni.
- Gli stessi dati vengono richiesti più volte. Un’autorità di vigilanza, una banca, un investitore e un cliente possono chiedere ciascuno dati simili secondo ESRS, GRI, SFDR, l’ISSB o un proprio questionario.
- I framework si sovrappongono ma non coincidono. Mappare un’informativa su un’altra è un lavoro dettagliato e ripetitivo, in cui un modello ben ancorato alle fonti fa risparmiare più tempo.
- Il lavoro è ricco di documenti. Gli agenti sono più utili dove il lavoro dipende da documenti non strutturati, che è esattamente la natura dei dati di sostenibilità.
Perché richiede attenzione
- I report sono pubblici e sempre più spesso sottoposti ad assurance. Ai sensi della CSRD, le dichiarazioni di sostenibilità sono sottoposte ad assurance esterna. Un revisore deve poter vedere da dove proviene ogni dato e chi lo ha approvato.
- Gli errori hanno conseguenze. Un dato sbagliato in una informativa SFDR o in un report CSRD è un problema normativo e reputazionale, non un refuso.
- Un testo scorrevole non è una prova. Un modello può scrivere un paragrafo convincente su una policy che l’azienda non ha. Le informative descrittive richiedono la stessa verifica delle fonti dei numeri.
- Gli standard continuano a cambiare. Gli ESRS rivisti adottati nel 2026 hanno modificato numerazione e requisiti. Uno strumento basato sulla versione dell’anno scorso dà le risposte dell’anno scorso.
Come dovrebbe essere
In questo campo l’impostazione giusta non è un agente autonomo che deposita un report da solo. È un’IA che svolge il grosso della lettura e dell’abbinamento, con le persone saldamente al comando di ciò che viene approvato.
- L’IA legge i documenti e propone dove collocare ogni dato o affermazione.
- Ogni proposta rimanda al passaggio della fonte.
- Una persona esamina, accetta, modifica o rifiuta ogni proposta.
- Ogni decisione viene registrata in un log di audit.
- I dati approvati vengono riutilizzati tra i framework, così vengono verificati una volta e usati molte volte.
L’approccio di Generation Impact Global
VitAI™ è il livello di IA di Generation Impact Global. Segue l’approccio descritto sopra: l’IA legge e abbina, le persone decidono.
- Legge i vostri documenti e suggerisce dove collocare ogni dato nei framework secondo cui rendicontate, come ESRS, GRI, SFDR, VSME, SASB e TCFD.
- Esaminate ogni mappatura, e il log di audit conserva ogni decisione.
- Potete costruire il vostro framework: una nuova normativa, il codice di condotta per i fornitori di un cliente o la scorecard del vostro fondo.
- I dati approvati vengono riutilizzati tra i framework, grazie ai nostri livelli di interoperabilità e gestione dei dati .
I dati di fornitori, siti e società in portafoglio vengono raccolti con QB-EDGE™. Il nostro approccio alla protezione dei dati è descritto nelle pagine Sicurezza e Licenze e certificazioni .
Il funzionamento delle nostre funzionalità di IA e il modo in cui applichiamo l’AI Act dell’UE sono descritti nella nostra AI Transparency Notice e nel nostro articolo complementare, La regolamentazione dell’IA nel 2026.
Potete iniziare gratis, vedere i pianioppure prenotare una demo.
Dodici domande da porre a qualsiasi fornitore di IA
Usatele sia che stiate valutando noi sia chiunque altro. Un buon fornitore risponderà a ciascuna per iscritto.
Dati
- Quali modelli e fornitori di IA utilizzate, e dove vengono trattati i miei dati?
- I miei contenuti vengono usati per addestrare qualche modello? Posso verificarlo nel contratto?
- Per quanto tempo voi e i vostri fornitori conservate i miei contenuti e i log?
Controllo
- Posso vedere la fonte di ogni suggerimento dell’IA?
- Una persona approva l’output dell’IA prima che venga usato, e questa approvazione viene registrata?
- L’IA può compiere azioni in autonomia, e quali limiti la fermano?
Sicurezza
- Quali certificazioni indipendenti possedete (per esempio ISO/IEC 27001)?
- Come testate le funzionalità di IA contro la prompt injection e altri attacchi?
Manutenzione
- Che cosa succede quando il vostro fornitore di modelli ritira un modello? Come ripetete i test?
- Con quale rapidità vi aggiornate quando cambia uno standard di rendicontazione?
Regolamentazione
- Come avete classificato le vostre funzionalità di IA ai sensi dell’AI Act dell’UE, e la classificazione è pubblica?
- Posso esportare i miei dati e il log di audit se vado via?
Glossario
| Termine | Significato semplice |
|---|---|
| Modello linguistico di grandi dimensioni (LLM) | Software addestrato su grandi quantità di testo per prevedere e generare linguaggio |
| Agente di IA | Un sistema in cui un modello linguistico pianifica i passaggi, usa strumenti e verifica i risultati per raggiungere un obiettivo |
| IA agentica | La famiglia generale di sistemi di IA che agiscono con una certa autonomia, dai workflow fissi agli agenti veri e propri |
| Workflow | Una sequenza fissa di passaggi di IA e software, scritta in anticipo da uno sviluppatore |
| Strumento | Una funzione che un agente può richiamare: cercare, calcolare, leggere un file, inviare un messaggio |
| Finestra di contesto | La quantità di testo che un modello può vedere in una volta |
| Allucinazione | Un’affermazione scorrevole e sicura che però è falsa |
| Grounding | Far rispondere il modello solo sulla base dei documenti forniti |
| Recupero (RAG) | Cercare nei vostri documenti e fornire al modello solo i passaggi pertinenti |
| Prompt injection | Istruzioni nascoste in un contenuto che inducono un agente a fare qualcosa di non previsto |
| Eccessiva autonomia (excessive agency) | Un agente con più strumenti, accessi o libertà di quanto richieda il suo compito |
| MCP | Model Context Protocol, uno standard aperto per collegare gli strumenti di IA alle fonti di dati |
| A2A | Agent2Agent, uno standard aperto che consente ad agenti di fornitori diversi di lavorare insieme |
| Eval | Test strutturati che misurano se un sistema di IA svolge il proprio compito in modo affidabile |
| Log di audit | Un registro di ciò che l’IA ha proposto e di ciò che una persona ha approvato |
Domande frequenti
Che cos’è un agente di IA?
Un agente di IA è un software costruito attorno a un modello linguistico che riceve un obiettivo, pianifica i passaggi, usa strumenti come la ricerca o il calcolo per eseguirli, verifica i risultati e ripete il ciclo finché l’obiettivo non è raggiunto o finché non serve la decisione di una persona.
Qual è la differenza tra IA generativa e IA agentica?
L’IA generativa crea contenuti; l’IA agentica li usa per compiere passi verso un obiettivo. L’IA generativa produce testi o immagini in risposta a un prompt. L’IA agentica usa un modello generativo all’interno di un ciclo, così da poter pianificare, usare strumenti e compiere passi verso un obiettivo. Tutti gli agenti usano l’IA generativa; non tutta l’IA generativa è agentica.
Gli agenti di IA sono abbastanza affidabili per l’uso aziendale?
Per attività ben definite, con dati di qualità e revisione umana, sì. Ma anche il miglior modello nei risultati di Google di settembre 2026 ha completato solo circa la metà delle automazioni aziendali realistiche, e OpenAI ha rilevato che gli agenti si comportano in modo diverso nei test e nell’uso reale. Usarli senza supervisione su attività importanti non è ancora prudente.
Gli agenti di IA sostituiscono i team di sostenibilità?
No. Eliminano gran parte del lavoro di lettura, ricerca e abbinamento. Il giudizio sulla rilevanza, l’approvazione dei dati e la responsabilità del report restano alle persone, ed è ciò che si aspettano le autorità di regolamentazione.
Costruire un agente in proprio costa meno?
Il prototipo costa poco. Test, sicurezza, monitoraggio, ritiro dei modelli e regolamentazione sono costi continui, e le persone in grado di svolgere questo lavoro sono poche. Nel 2026 il MIT ha rilevato che la maggior parte delle grandi aziende acquista l’IA come servizio e che quasi nessuna banca ha raggiunto un’integrazione profonda.
I miei dati vengono usati per addestrare i modelli di IA?
Dipende dal fornitore e dal contratto. Chiedetelo per iscritto. Il modo in cui Generation Impact Global tratta i dati nelle sue funzionalità di IA è descritto nella nostra AI Transparency Notice.
Che cos’è MCP e perché dovrebbe interessarmi?
MCP è uno standard aperto che consente agli strumenti di IA di collegarsi alle fonti di dati senza integrazioni personalizzate. Le piattaforme che lo supportano sono più facili da collegare al resto dei vostri sistemi.
L’AI Act dell’UE si applica agli agenti di IA?
L’AI Act disciplina i sistemi di IA in base all’uso e al livello di rischio, non in base al fatto che siano agenti. Il nostro articolo complementare spiega che cosa si applica e quando.
Altre letture sul nostro sito
- La regolamentazione dell’IA nel 2026: l’AI Act dell’UE, le regole globali e come le applichiamo
- VitAI™: costruite il vostro framework e mappate i vostri documenti
- Rendicontazione di sostenibilità e Intelligence sui dati ESG
- ESG per investimenti e finanza
- Le regole ESG dell’EBA sono operative: le banche ora hanno bisogno dei dati ESG dei propri clienti
- Guide: Hub CSRD, Hub SFDR, Tassonomia UE
- Valutazione della doppia rilevanza
- Integrazioni e API e Sviluppatori
- Strumenti gratuiti
Fonti
Tutte le fonti seguenti sono state pubblicate tra agosto e novembre 2026, salvo quelle indicate come documentazione di riferimento.
Stanford University
- Stanford HAI, Want employees to embrace AI? Stop selling it as a productivity tool, 7 ottobre 2026
- Stanford HAI, The tests that grade AI may be getting it wrong, 25 settembre 2026
- Stanford HAI, Can AI be slowed down? Stanford HAI experts weigh the risks, 22 settembre 2026
- Shi, Zhang and Yang, Emergent collusion in long-horizon LLM agent interaction, preprint, settembre 2026
- Wu, Pappu, Zou et al., Measuring AI agents as teammates with collaborative intelligence, preprint, 2 novembre 2026
MIT
- MIT Initiative on the Digital Economy, Pulling back the curtain on enterprise AI adoption, 16 settembre 2026
- MIT CISR, AI value creation: five provocative propositions, 20 agosto 2026
- MIT Sloan, 4 areas where companies need AI guardrails, 9 novembre 2026
Anthropic
- Introducing Claude Opus 5.5, 22 settembre 2026
- Introducing Claude Fable 5.2 and Claude Mythos 5.2, 9 novembre 2026
- The components of agent memory, 6 novembre 2026
- How AI agents shape experts’ judgment calls, 27 ottobre 2026
- Building agents: when to fold subagents into your main agent loop, 22 ottobre 2026
- Donating Agent Skills to the Agentic AI Foundation, 22 ottobre 2026
- Investigating unintended model actions in our evaluations and internal use, 9 ottobre 2026
- Anthropic invests $100 million to train 10,000 engineers, 2 ottobre 2026
- Illuminating the frontier: measuring the pace of AI development, dati aggiornati ad agosto 2026
- Countering misuse of AI: September 2026
- Claude Platform release notes, voci da agosto a novembre 2026
- Model deprecations e Reduce hallucinations, documentazione di riferimento
OpenAI
- Eval-production behavior gaps in agent safety, 3 novembre 2026
- How we detect frontier model misalignment, 29 ottobre 2026
- Addendum to GPT-6 Astra system card: GPT-6.1 Sol, 29 settembre 2026
- GPT-6 Astra system card: prompt injection, 3 settembre 2026
- API changelog, voci da agosto a ottobre 2026
Google and Google DeepMind
- Gemini 4 Carbon: our next frontier model, 28 ottobre 2026
- Developing Gemini 4 Argon responsibly and safely, 13 ottobre 2026
- Welcome to Gemini at Work 2026: introducing the Gemini agent, 8 ottobre 2026
- Gemini 4 Argon: our next era of frontier intelligence, 30 settembre 2026
- Mandiant, AI risk and resilience in 2026, settembre 2026
Standard e ricerca indipendente
- OWASP GenAI Security Project, 2026 Top 10 for LLM applications and Agent Control Standard, 1° settembre 2026
- OWASP GenAI Security Project, GenAI and agentic AI exploit roundup Q3 2026, 8 ottobre 2026
- Agentic AI Foundation, A2A joins AAIF, 17 agosto 2026
- Linux Foundation, Agentic AI Foundation welcomes 57 new members, 13 agosto 2026
- Model Context Protocol, The new MCP roadmap, 22 agosto 2026
- METR, Independent assessment of AI R&D acceleration at Anthropic, 5 novembre 2026, e Task-completion time horizons, aggiornato l’8 settembre 2026
Generation Impact Global
- AI Transparency Notice, ultimo aggiornamento 2 settembre 2026